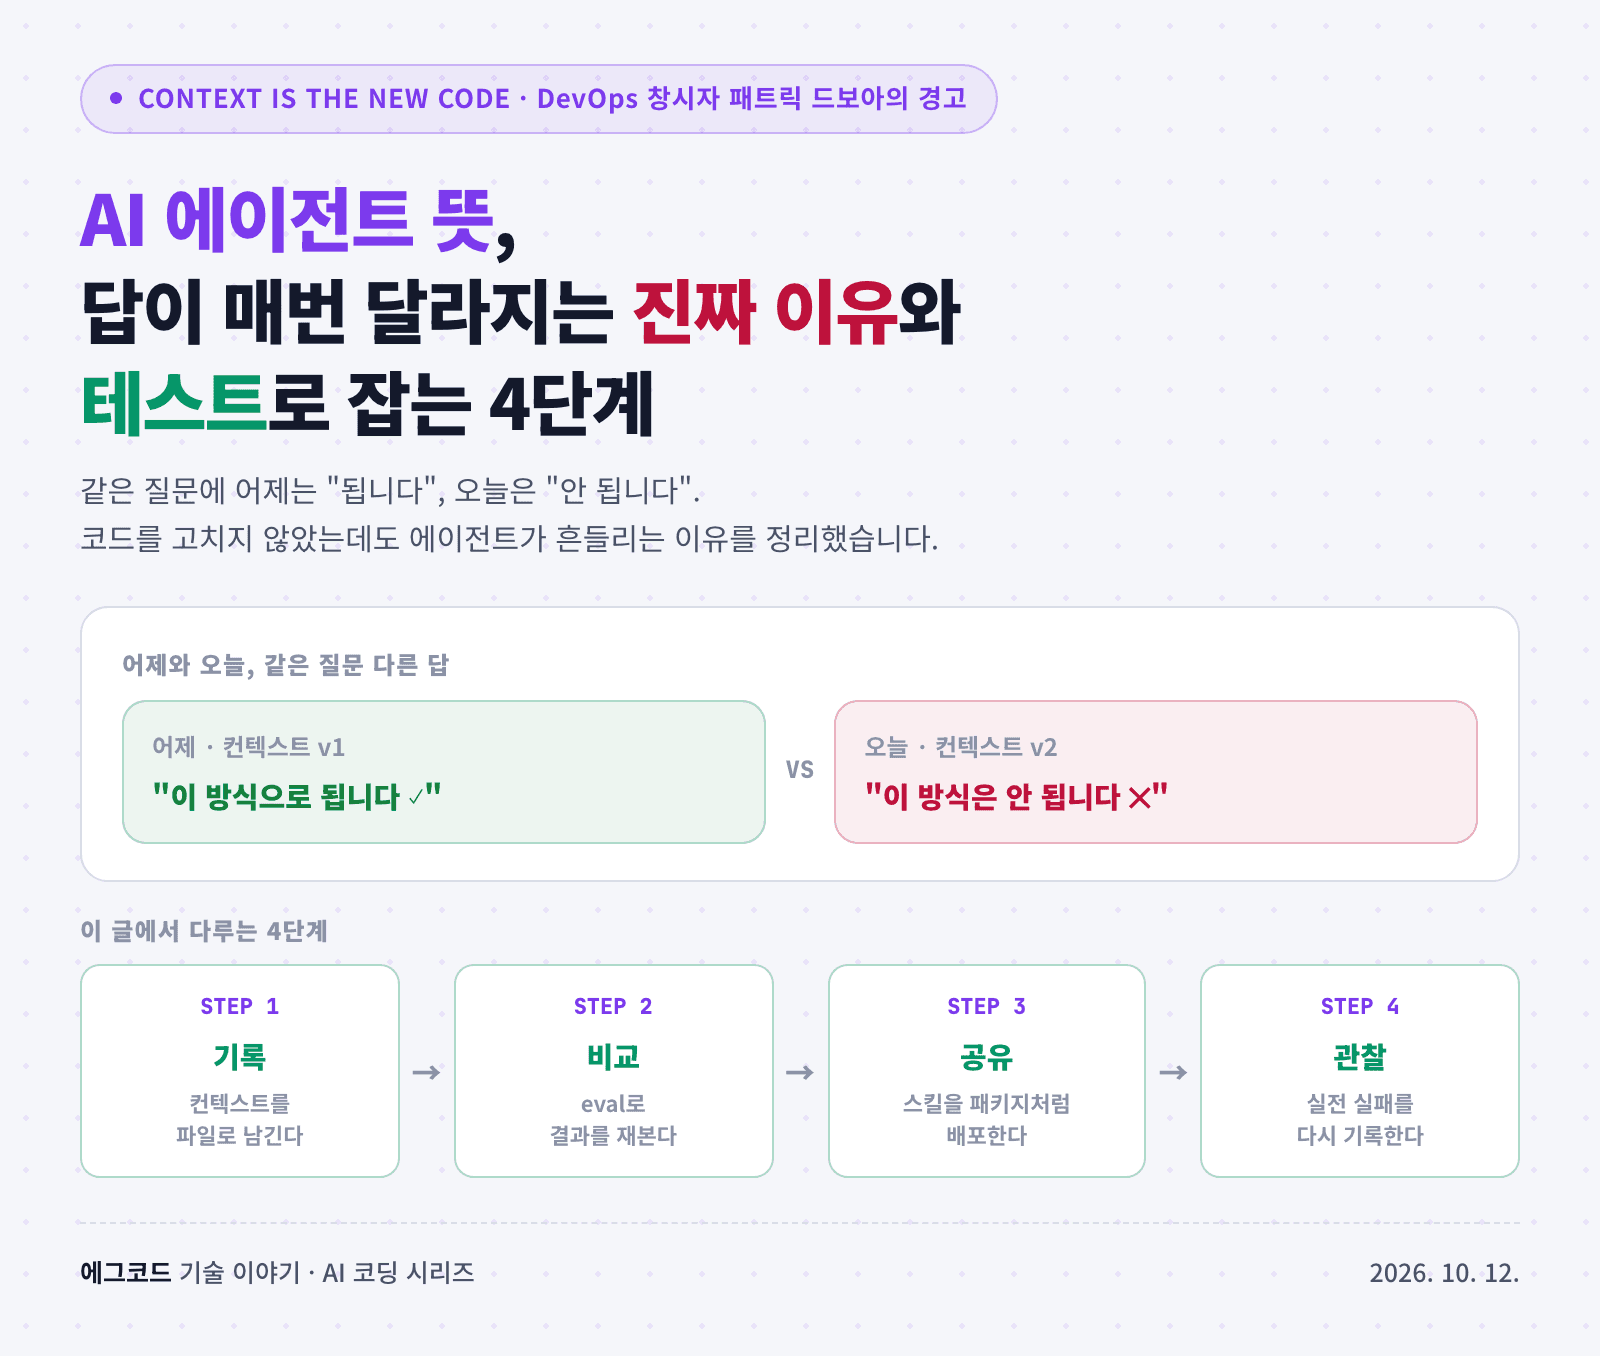
어제 잘 대답하던 AI 에이전트가, 오늘은 다른 답을 내놓은 경험이 있으신가요?
같은 질문에 어제는 된다고 하고, 오늘은 안 된다고 합니다.
코드를 고친 적도, 설정을 바꾼 적도 없는데 말입니다.
이 불안의 정체를 DevOps의 아버지로 불리는 패트릭 드보아(Patrick Debois)가 짚었습니다.
지난 9월 QCon 강연 "Context is the New Code"에서 나온 이야기입니다.
이 글에서는 AI 에이전트 뜻부터 답이 매번 달라지는 원인, 그리고 그것을 테스트로 잡는 4단계까지 정리합니다.
하나. AI 에이전트 뜻, 챗봇과 무엇이 다른가
AI 에이전트 뜻을 한 문장으로 말하면, 스스로 계획을 세우고 도구를 사용해 작업을 수행하는 AI입니다.
챗봇은 답을 알려주는 데서 끝나지만, 에이전트는 직접 파일을 고치고 명령을 실행합니다.
"이 버그 고쳐줘"라고 말하면 코드를 찾아보고, 수정하고, 테스트까지 돌려 봅니다.
이때 에이전트의 행동을 결정하는 것이 컨텍스트입니다.
컨텍스트는 에이전트가 일하기 전에 읽는 작업 지침서입니다.
클로드코드의 CLAUDE.md가 대표적이고, 작업 절차를 담은 스킬(skill)도 같은 부류입니다.
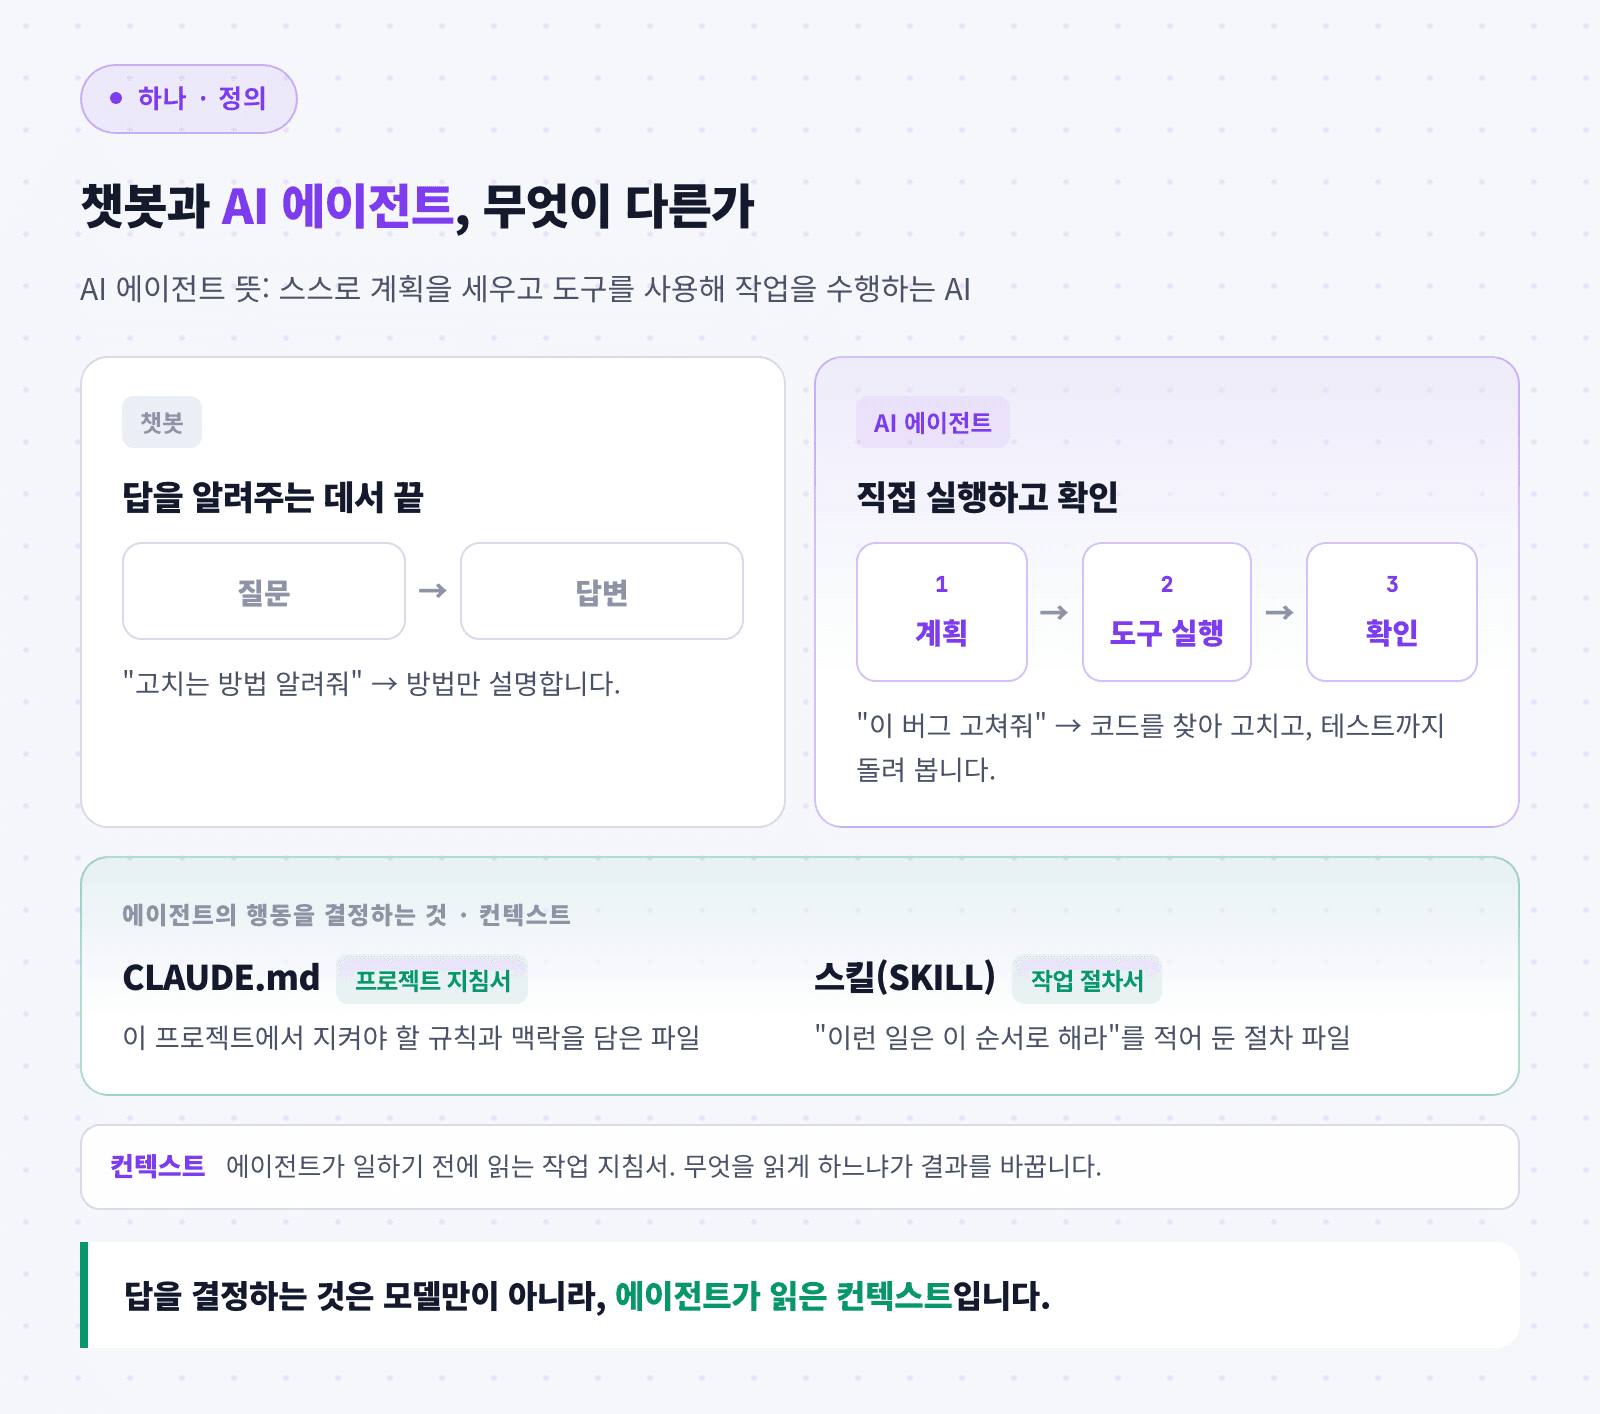
답을 결정하는 것은 모델만이 아니라, 에이전트가 읽은 컨텍스트입니다.
둘. 답이 매번 달라지는 진짜 이유
첫 번째 이유는 LLM의 성격 때문입니다.
LLM은 확률로 다음 단어를 고르기 때문에, 같은 질문에도 답이 조금씩 흔들립니다.
두 번째이자 더 큰 이유는 컨텍스트가 바뀌기 때문입니다.
어제와 오늘 사이에 CLAUDE.md에 한 줄이 추가됐을 수 있고, 스킬이 업데이트됐을 수 있습니다.
코드를 고치면 프로그램의 동작이 바뀌듯, 컨텍스트를 고치면 에이전트의 동작이 바뀝니다.
드보아는 이것을 "컨텍스트도 코드다"라고 정리했습니다.
그의 회사는 온보딩 예외 처리를 위해 많은 코드를 작성했습니다.
결국 자연어로 쓴 스킬 몇 줄로 압축한 사례를 소개합니다.
수백 줄의 코드가 몇 마디의 지침으로 대체된 것입니다.
그런데 문제는 여기 있습니다.
우리는 코드는 테스트하면서, 컨텍스트는 테스트 없이 바꾸고 있습니다.
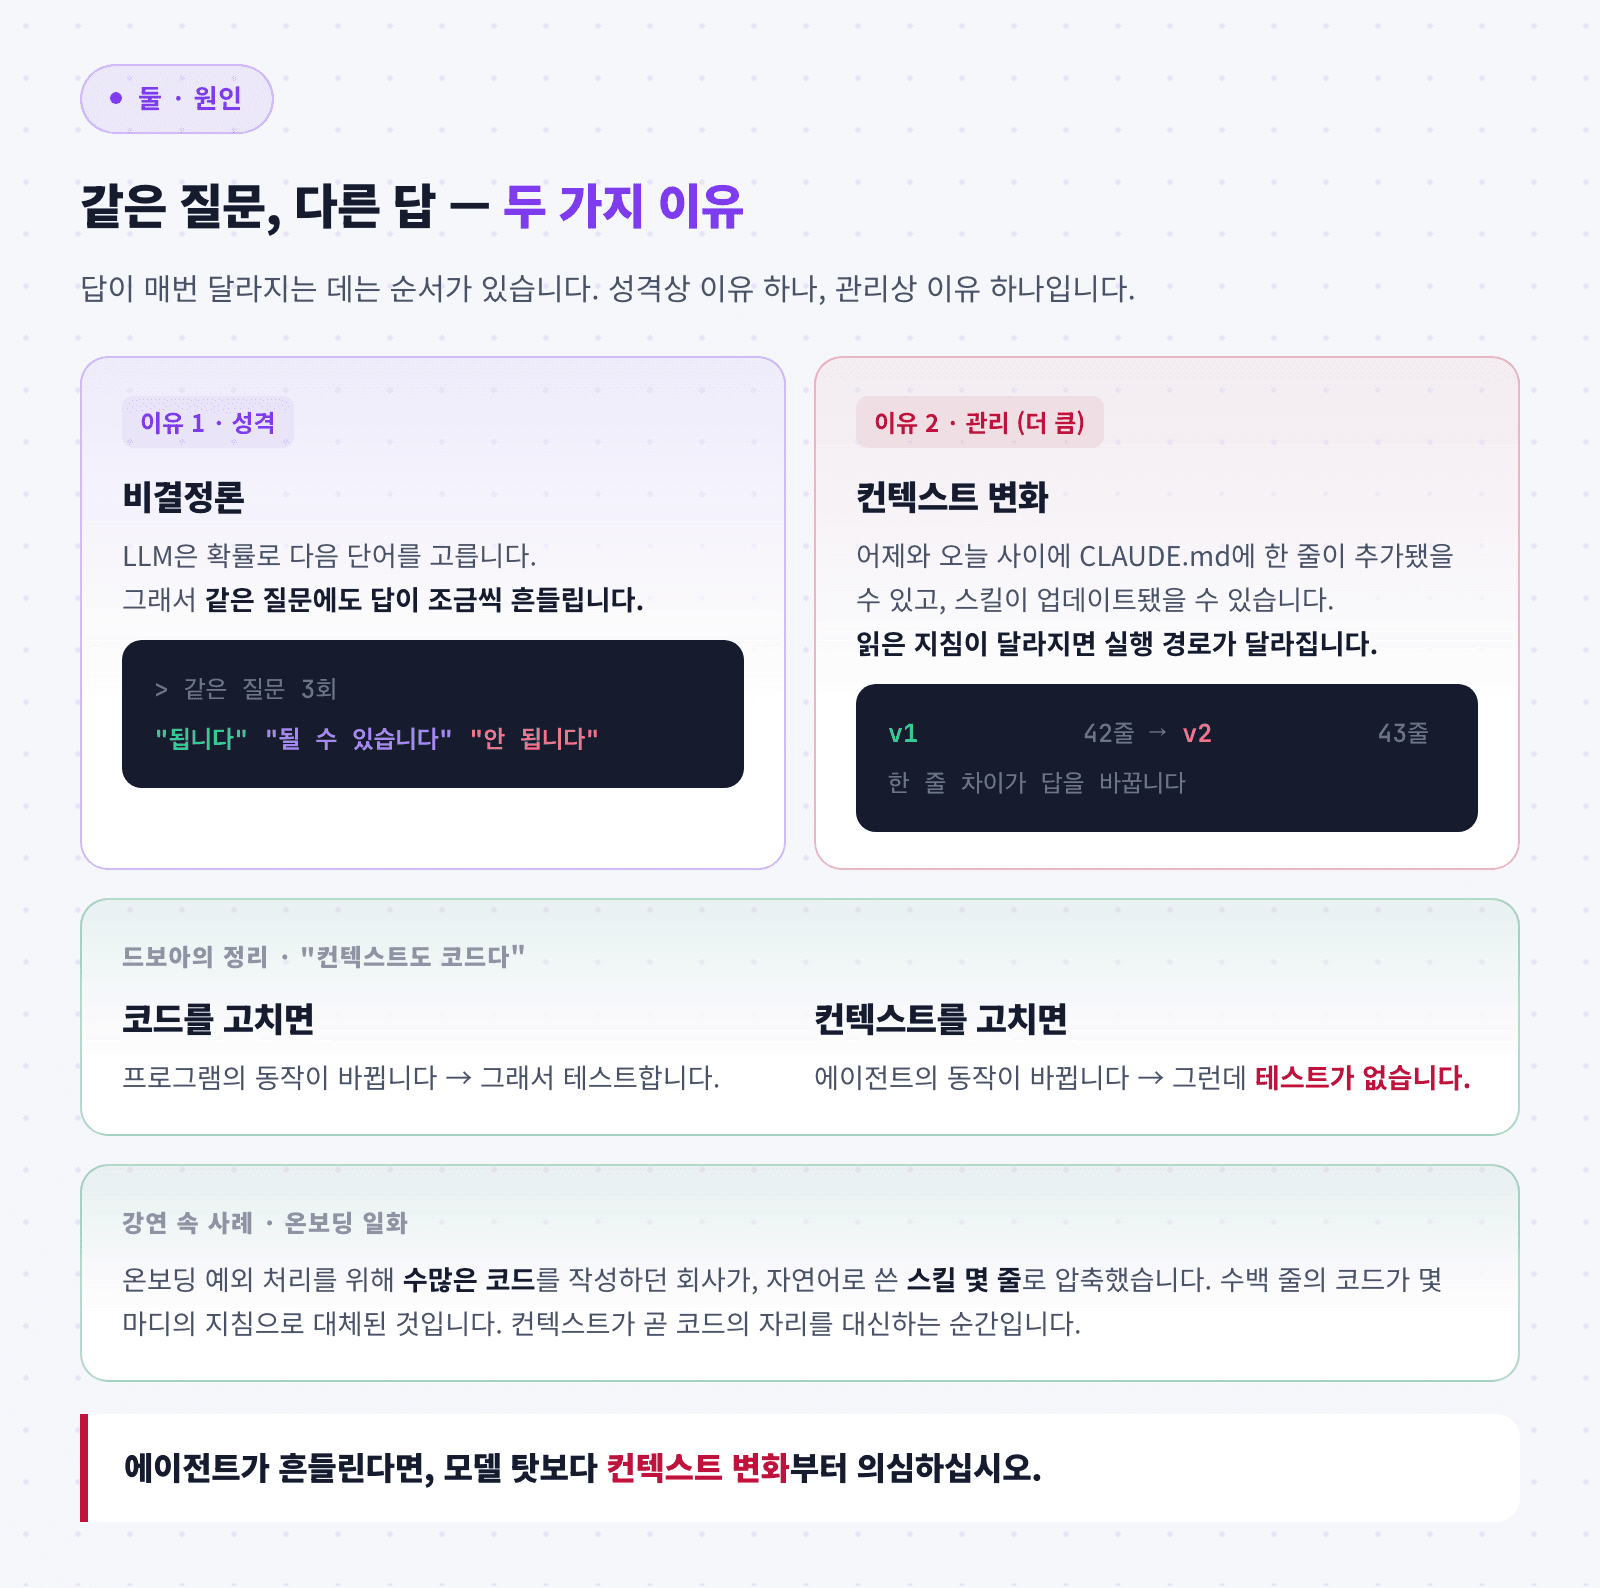
에이전트가 흔들린다면, 모델 탓보다 컨텍스트 변화부터 의심하십시오.
셋. 테스트로 잡는 4단계
강연은 소프트웨어 개발 주기를 컨텍스트에 그대로 이식할 것을 제안합니다.
실행 절차를 네 단계로 정리하면 다음과 같습니다.
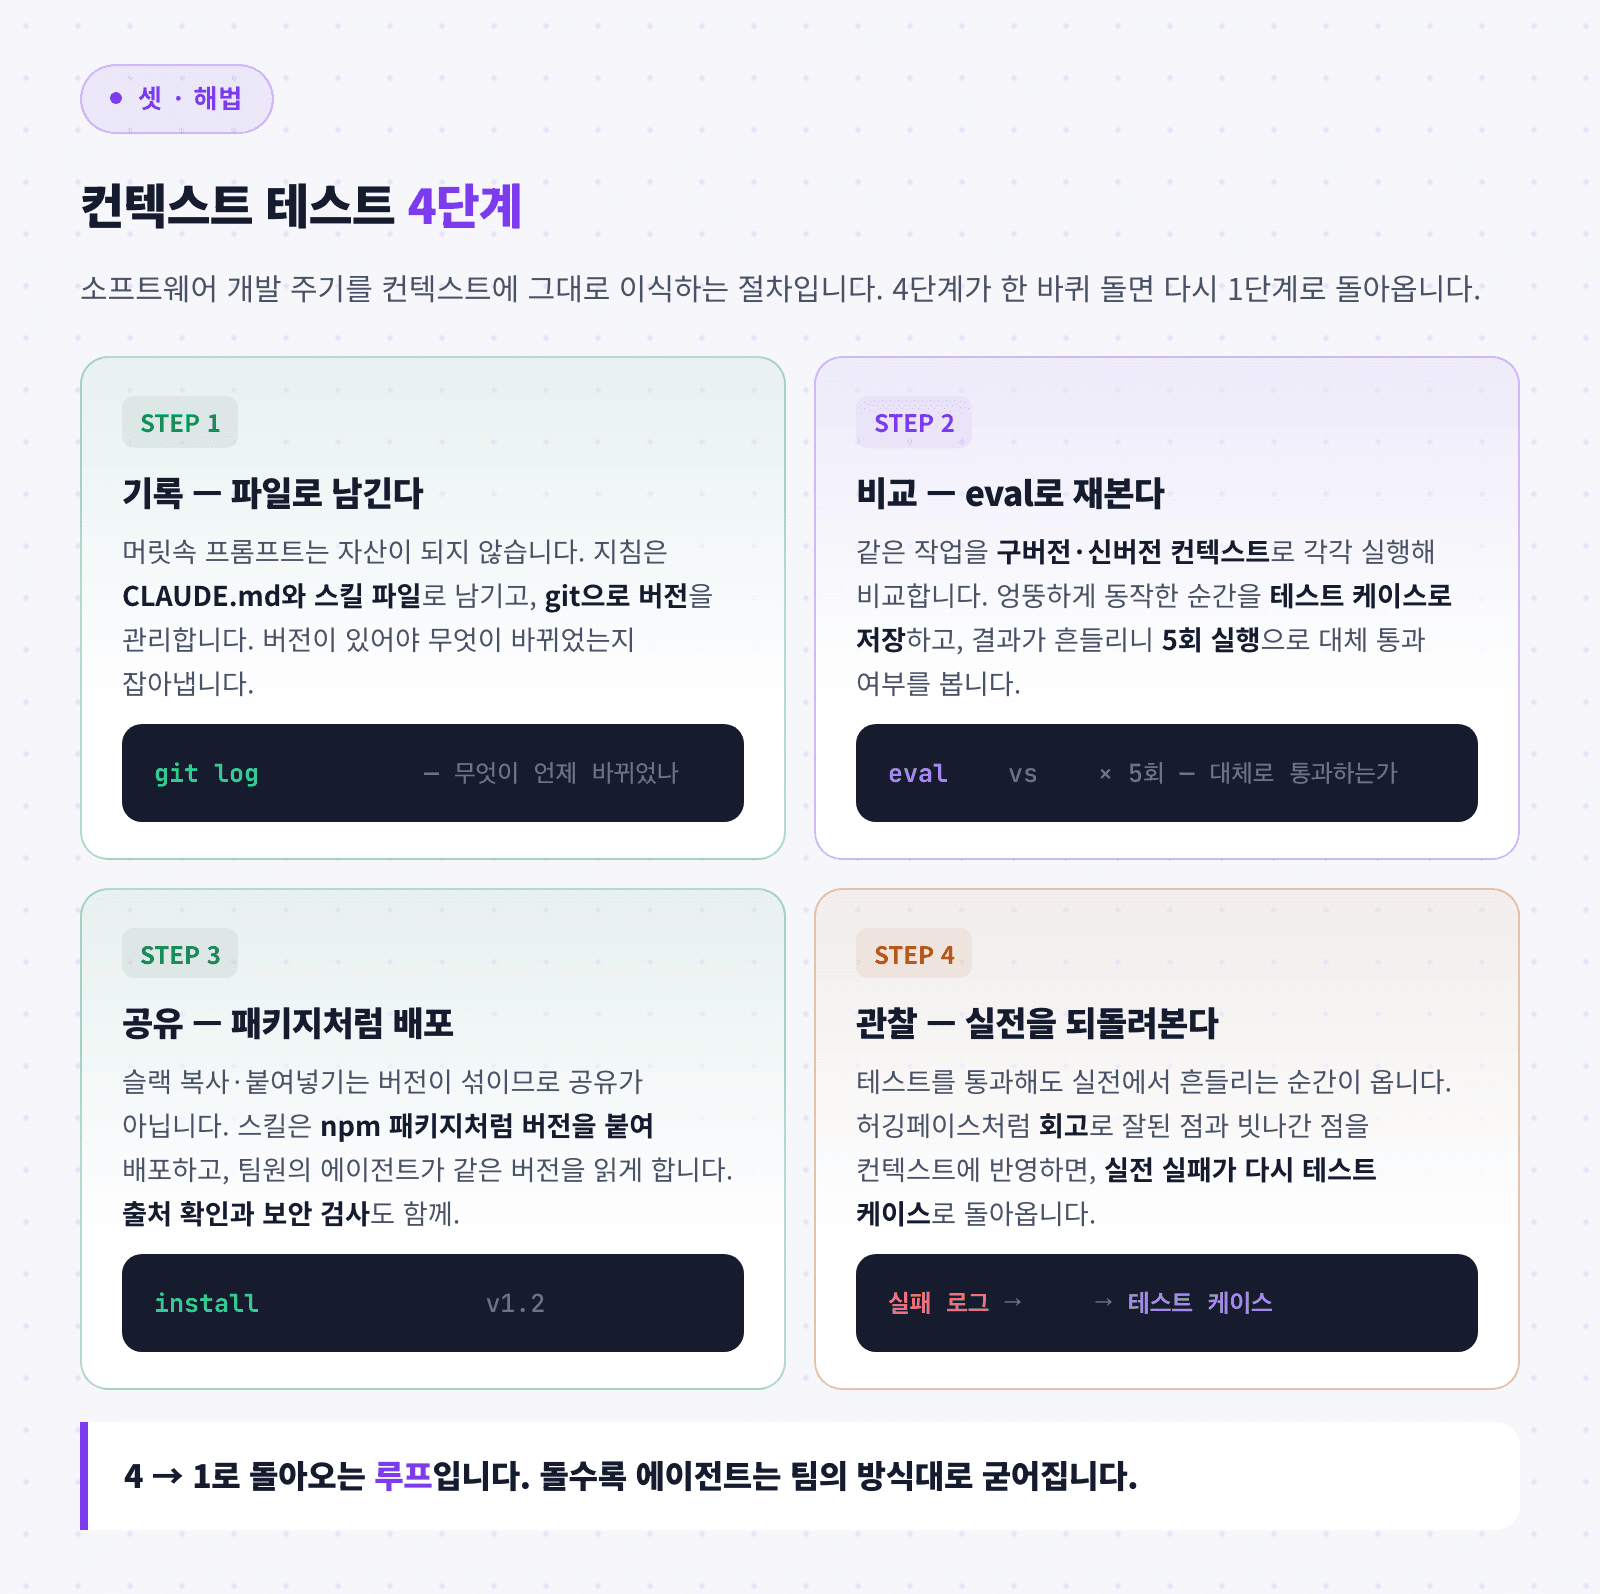
1단계. 기록 — 컨텍스트를 파일로 남깁니다
머릿속 프롬프트는 자산이 되지 않습니다.
지침은 CLAUDE.md와 스킬 파일로 남기고, git으로 버전을 관리합니다.
버전이 남아 있어야 무엇이 바뀌었는지 잡아낼 수 있습니다.
2단계. 비교 — eval로 결과를 재고합니다
컨텍스트의 테스트 코드가 eval입니다.
같은 작업을 구버전 컨텍스트와 신버전 컨텍스트로 각각 실행하고, 결과가 나아졌는지 비교합니다.
에이전트가 엉뚱하게 동작한 순간이 생기면, 그 순간을 그대로 테스트 케이스로 저장합니다.
수정 후 같은 케이스를 통과하는지 확인하면, 고친 것이 실제로 나아진 것인지 알 수 있습니다.
결과가 매번 조금씩 다르므로, 같은 케이스를 5회 정도 실행해 대체로 통과하는지 봅니다.
3단계. 공유 — 스킬을 팀의 패키지처럼 배포합니다
잘 만든 컨텍스트를 슬랙에 복사해서 붙이는 것은 공유가 아닙니다.
버전이 섞이고, 누가 어떤 버전을 쓰는지 알 수 없기 때문입니다.
스킬은 npm 패키지처럼 버전을 붙여 배포하고, 팀원의 에이전트가 같은 버전을 읽게 합니다.
악성 스킬 사건이 화제가 된 뒤에는, 출처를 확인하고 보안 검사를 거치는 장치도 등장하고 있습니다.
4단계. 관찰 — 실전에서 흔들린 순간을 다시 기록합니다
테스트를 통과해도 실전에서 흔들리는 순간이 옵니다.
허깅페이스는 에이전트 작업이 끝나면 회고를 돌려, 잘된 점과 빗나간 점을 컨텍스트에 반영합니다.
실전의 실패가 다시 테스트 케이스로 돌아오는 구조입니다.
이 루프가 돌수록, 에이전트는 팀의 방식대로 점점 굳어집니다.
출시 판단은 여전히 사람의 몫입니다
테스트를 갖춰도 완벽해지지는 않습니다.
eval 열 개 중 아홉 개가 통과하면 출시할 수 있을까요?
이 판단은 여전히 사람이 합니다.
현실적인 접근은 기능마다 허용 오차를 나누는 것입니다.
핵심 기능은 기준을 엄격하게 잡고, 보조 기능은 넉넉하게 잡습니다.
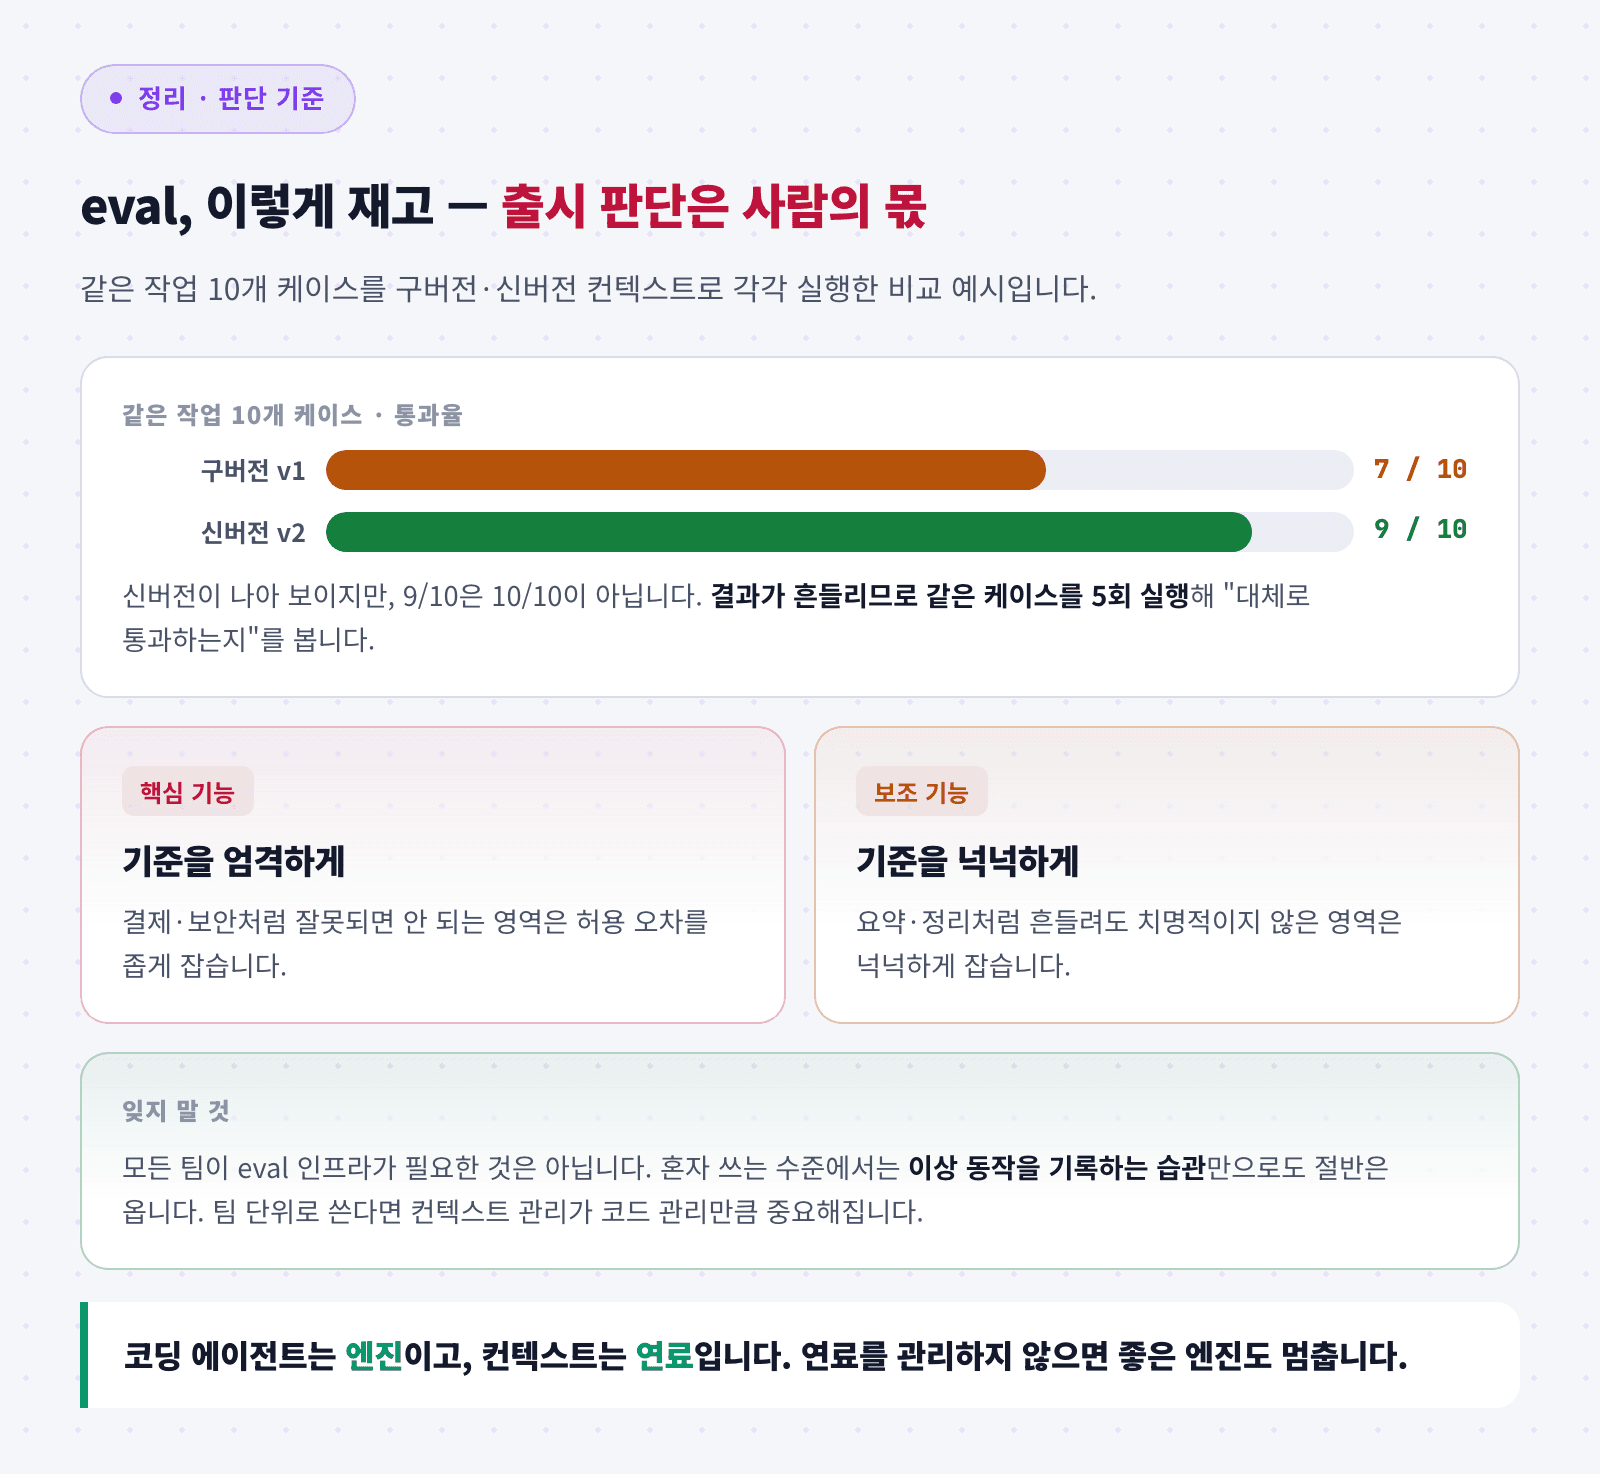
물론 모든 팀이 eval 인프라를 갖춰야 한다는 뜻은 아닙니다.
혼자 쓰는 수준에서는 이상 동작을 기록하는 습관만으로도 절반은 옵니다.
다만 팀 단위로 AI 에이전트를 쓴다면, 컨텍스트 관리는 코드 관리만큼 중요한 일이 됩니다.
AI 에이전트 뜻을 한 문장으로 요약하면 도구를 쓰는 AI였고, 그 AI를 좌우하는 것은 컨텍스트입니다.
드보아의 표현을 빌리면, 코딩 에이전트는 엔진이고 컨텍스트는 연료입니다.
연료를 관리하지 않으면 좋은 엔진도 멈춥니다.
함께 읽어보세요 — 하네스 뜻, AI 코딩 성공률을 바꾼 검증 장치 · 대화가 길어질수록 AI가 헛소리하는 3가지 이유 · AX 구축, AI 에이전트부터 시작하는 5단계 로드맵 · 에그코드 MVP 개발 서비스