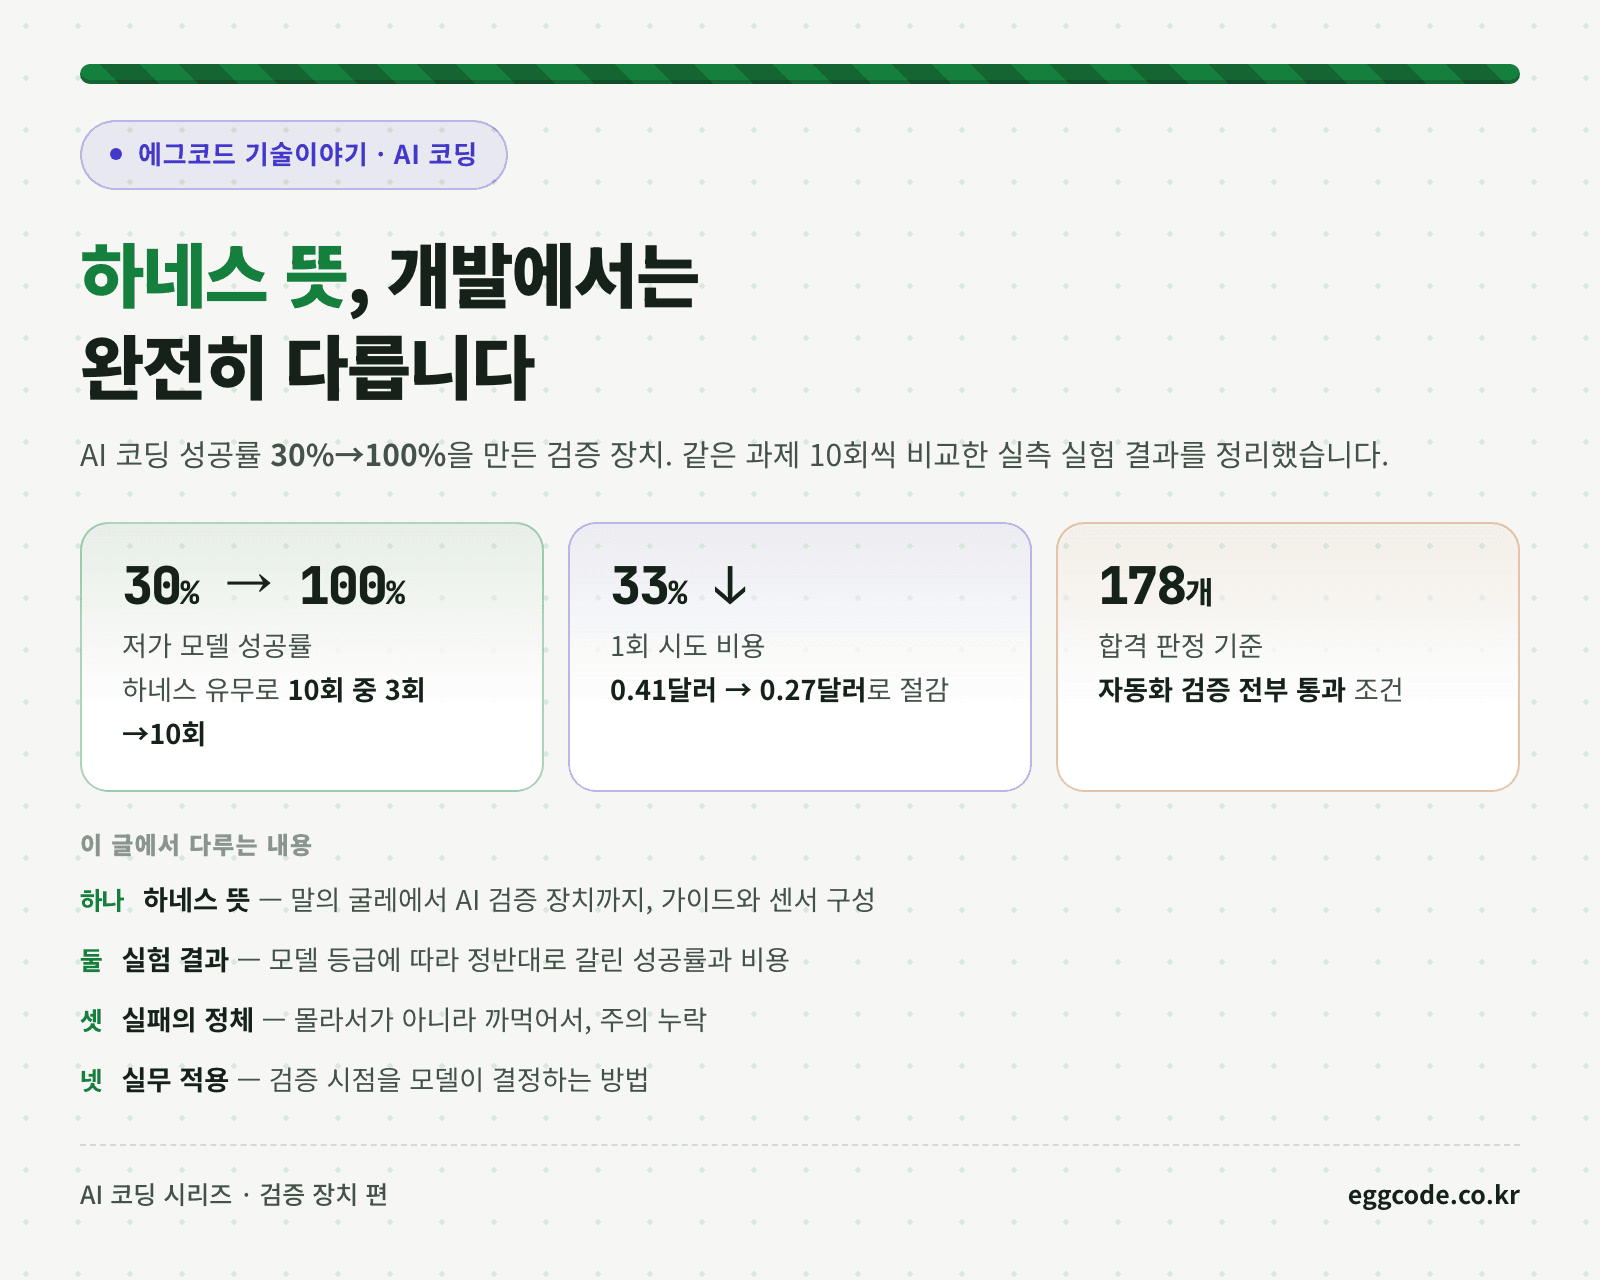
"AI한테 맡겼더니 어제는 잘 되더니, 오늘은 엉터리가 나왔어요."
개발 의뢰를 검토하다 보면 이런 경험담을 자주 듣습니다. 같은 도구에 같은 요청을 했는데 결과가 매번 달라지는 상황입니다. AI 코딩이 대중화된 지금, 품질의 들쭉날쭉함은 많은 팀이 겪는 문제가 되었습니다.
최근 소프트웨어 업계의 거장 마틴 파울러의 블로그에 흥미로운 실험이 공개됐습니다. AI 코딩 에이전트에 같은 서비스를 만들게 했습니다. 검증 장치인 하네스를 붙였을 때와 안 붙였을 때를 비교했고, 두 조건 모두 10회씩 수행됐습니다.
이 글에서는 하네스 뜻부터 실험 결과, 실패의 정체, 그리고 실무 적용 방법까지 정리합니다.
하나. 하네스 뜻: 말의 굴레에서 AI 검증 장치까지
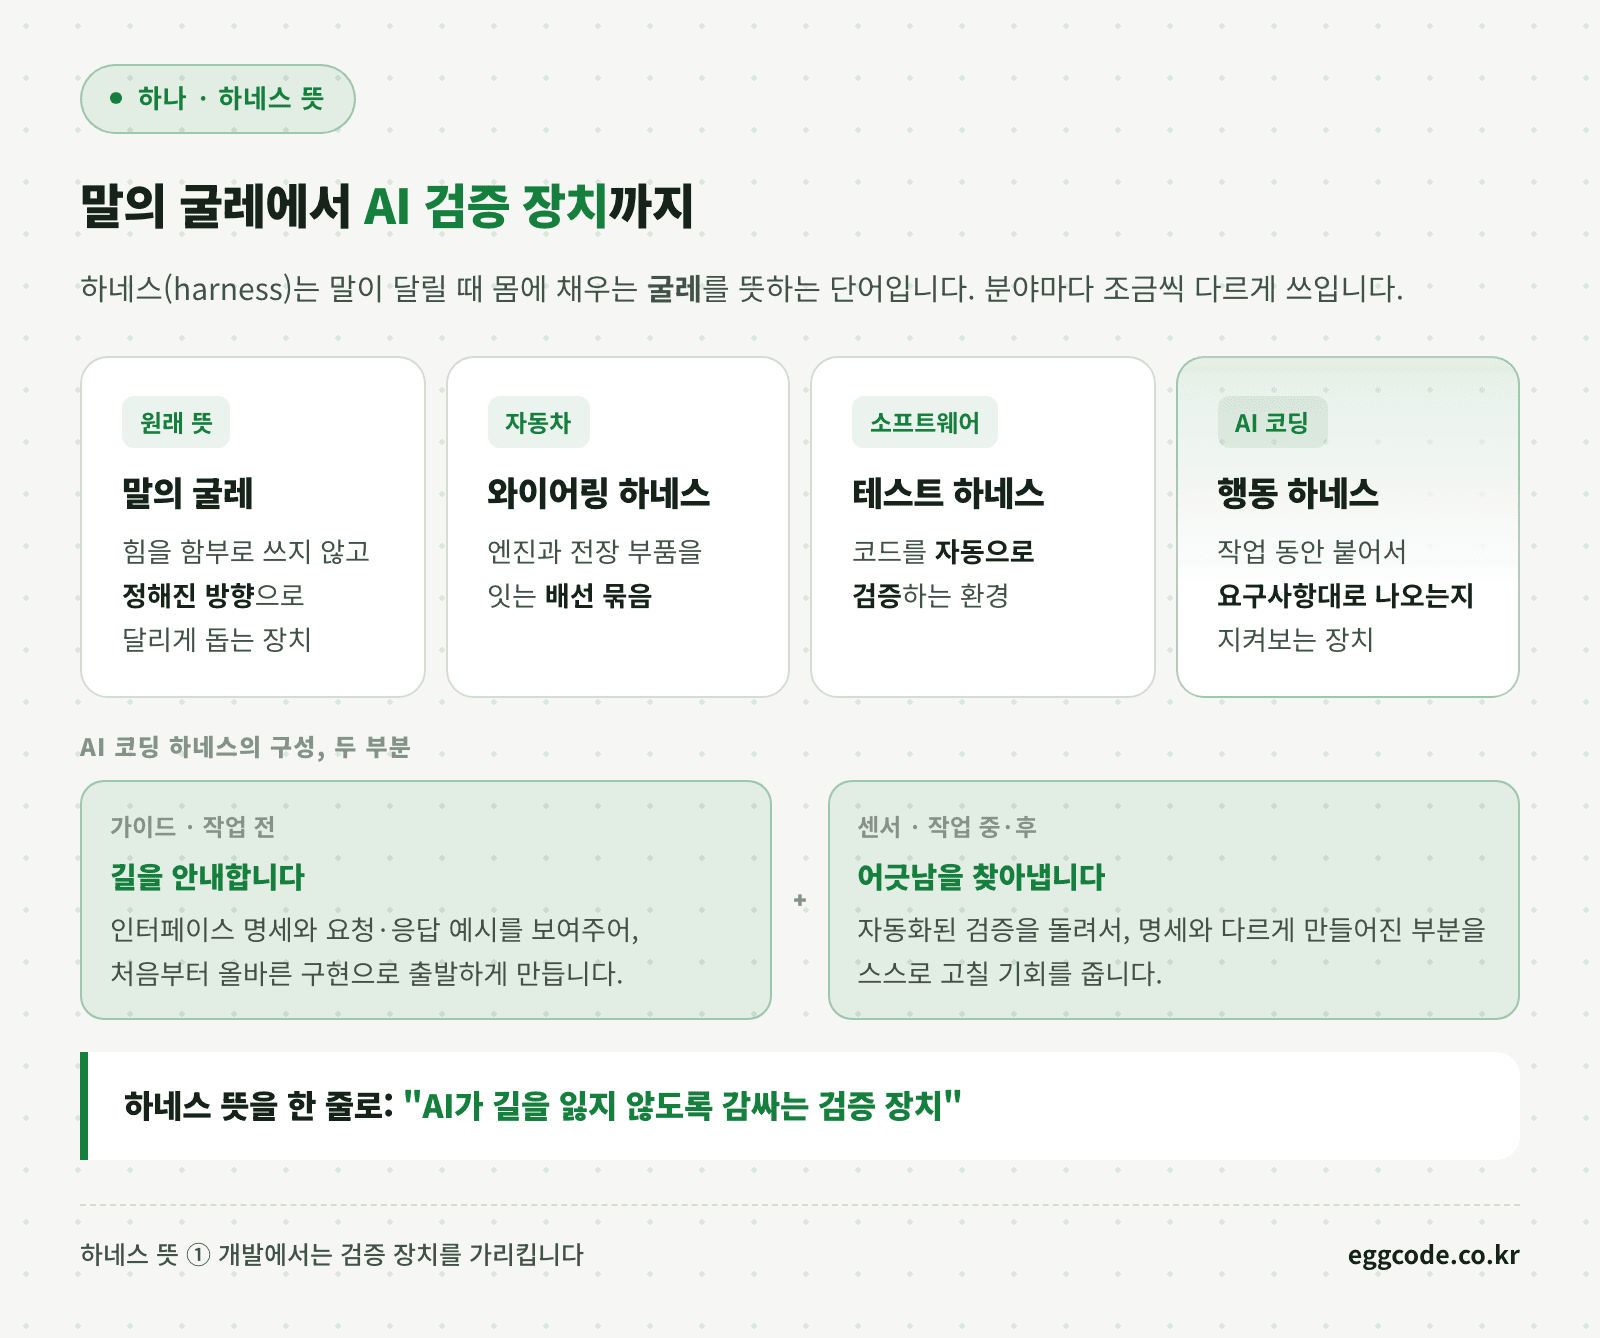
하네스(harness)는 원래 말이 달릴 때 몸에 채우는 굴레를 뜻하는 단어입니다. 말이 힘을 함부로 쓰지 않고 정해진 방향으로 달리도록 돕는 장치라는 의미입니다.
이 단어는 분야마다 조금씩 다르게 쓰입니다. 자동차에서는 엔진과 각종 전장 부품을 잇는 배선 묶음을 와이어링 하네스라고 부릅니다. 소프트웨어에서는 테스트 하네스라는 이름으로 코드를 자동으로 검증하는 환경을 가리킵니다.
AI 코딩에서의 하네스는 이런 개념들을 이어받은 것입니다. 실험에서는 이를 행동 하네스(behavioral harness)라고 불렀습니다. AI가 작업하는 동안 붙어서, 코드가 요구사항대로 나오는지 계속 지켜보는 장치라는 뜻입니다.
구성은 두 부분입니다. 가이드는 작업 전에 인터페이스 명세와 요청·응답 예시를 보여주어 길을 안내합니다. 센서는 작업 중과 작업 후에 자동화된 검증을 돌려서 어긋난 부분을 찾아냅니다.
요약: 하네스 뜻은 "AI가 길을 잃지 않도록 감싸는 검증 장치"입니다.
그래서 프로젝트에서 중요한 것은 AI에게 과제를 주는 방식만이 아닙니다. 검증 장치를 함께 준비했는지 여부입니다.
둘. 실험 결과: 모델 등급에 따라 정반대로 갈렸습니다
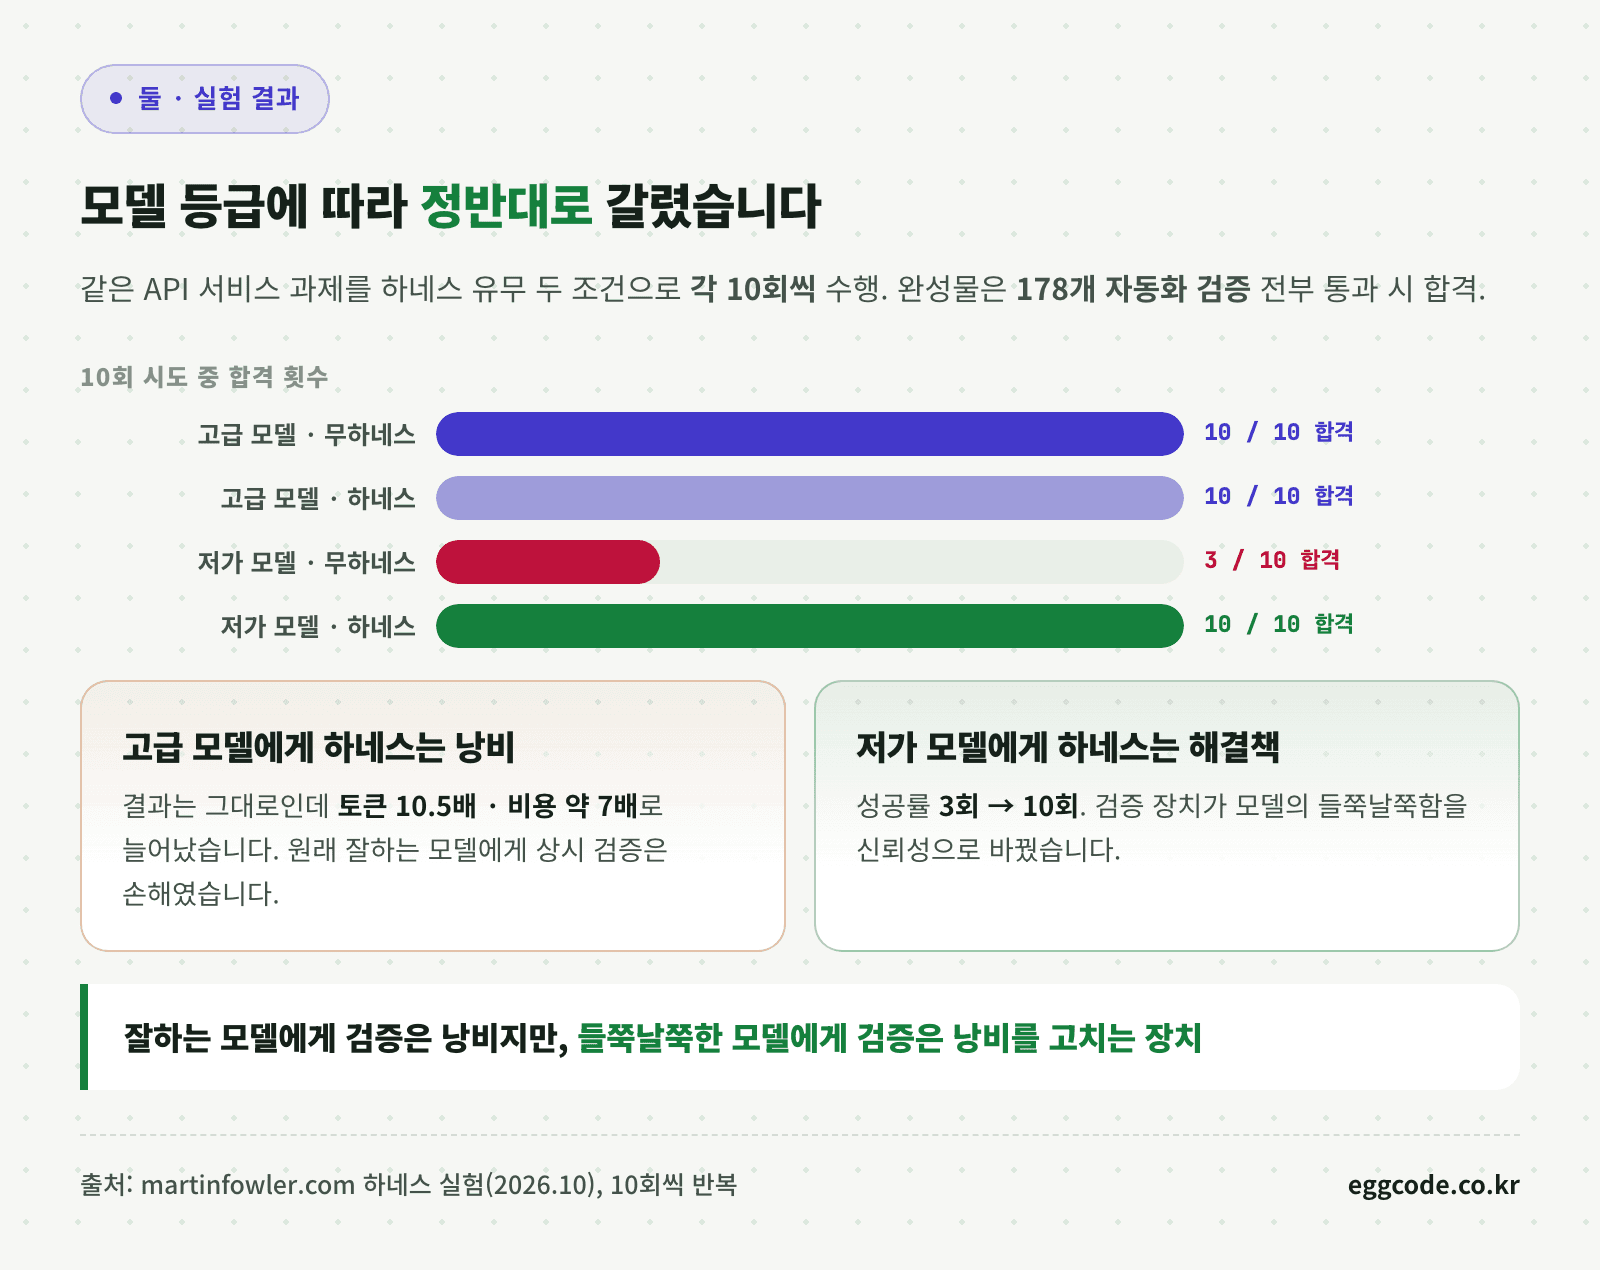
실험 방법은 단순합니다. 상품 검색 API 서비스를 만드는 상세한 요구사항을 주었습니다. 그리고 AI 에이전트에게 하네스 유무 두 조건으로 각각 10회씩 과제를 수행하게 했습니다.
완성된 서비스는 178개의 자동화 검증을 모두 통과해야 합격으로 판정됐습니다.
결과는 모델 등급에 따라 정반대로 갈렸습니다.
최상위급 모델(GPT-6 Sol)은 하네스 없이도 10회 전부 합격했습니다. 하네스를 붙이면 토큰 소모가 10.5배, 비용이 약 7배로 늘어났지만 결과는 그대로였습니다. 원래 잘하는 모델에게 상시 검증은 낭비였던 것입니다.
저가형 모델(GPT-6 Luna)은 사정이 달랐습니다. 하네스 없이는 10회 중 3회만 합격했지만, 하네스를 붙이자 10회 전부 합격으로 바뀌었습니다.
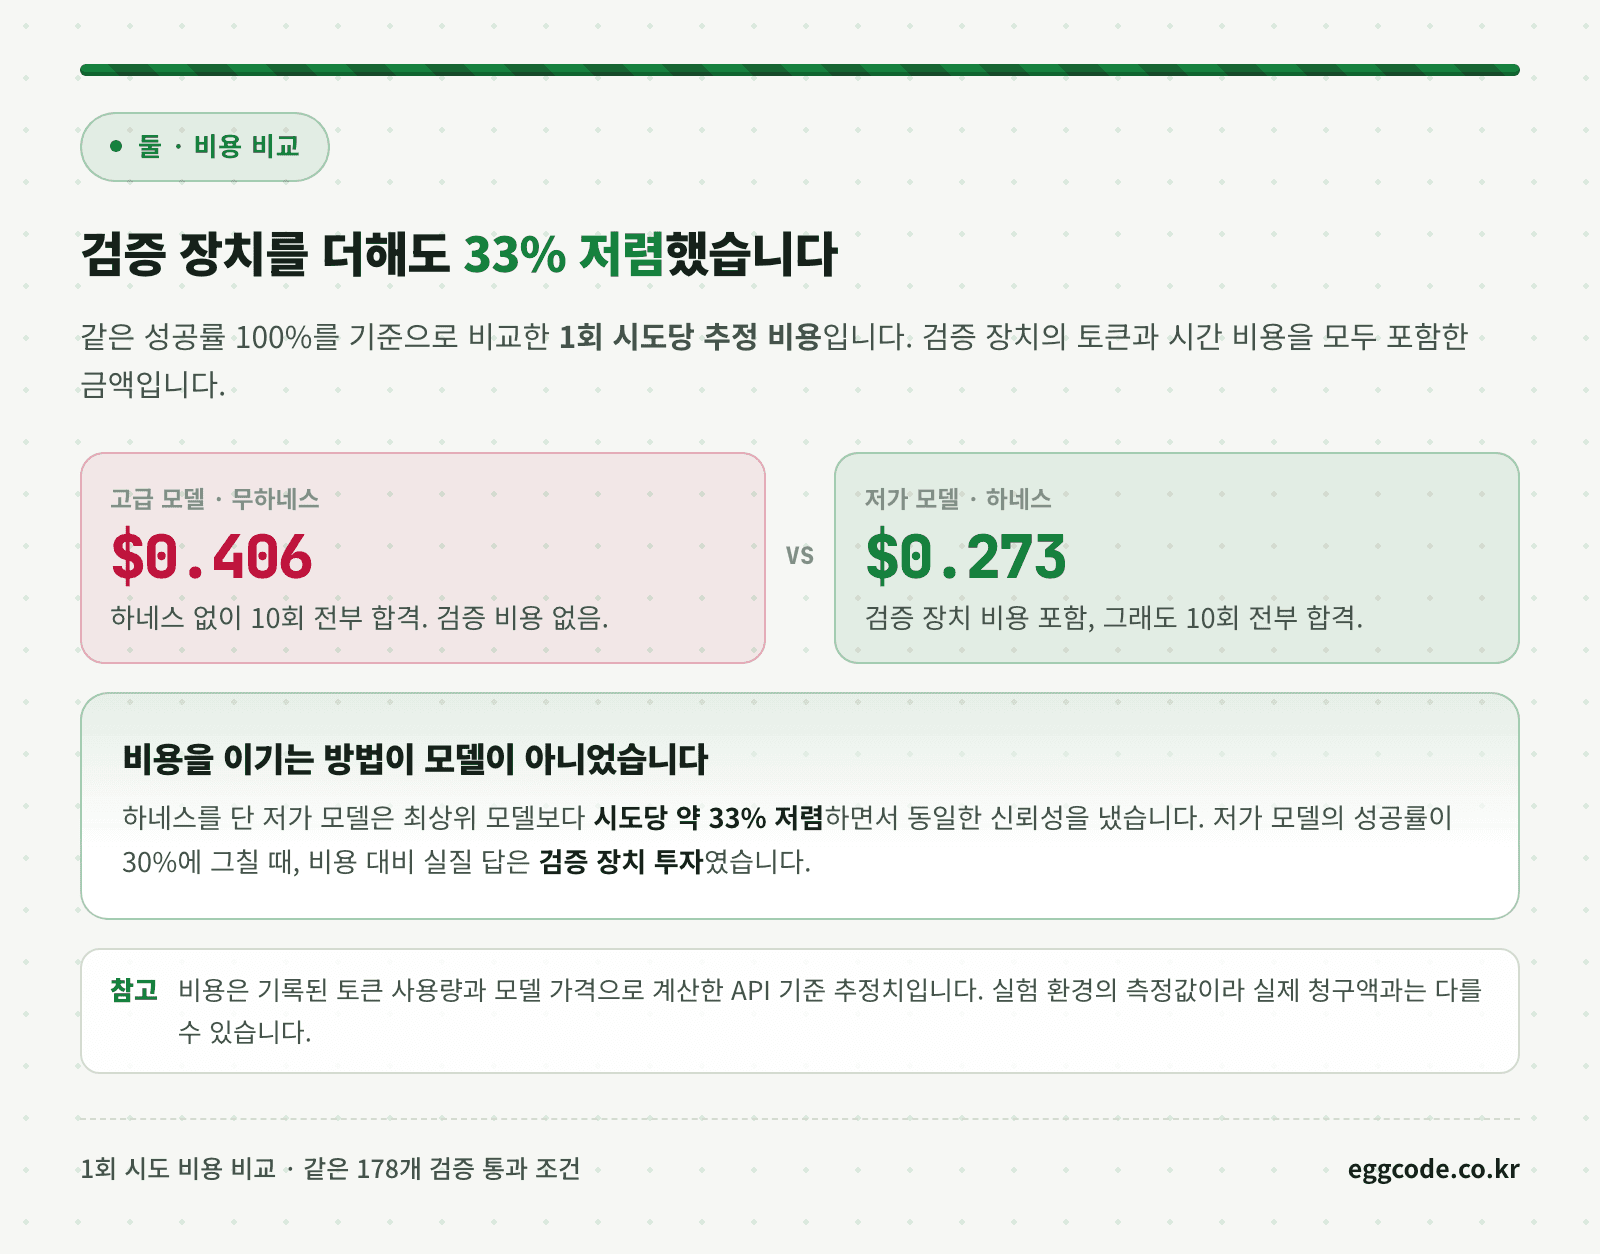
비용의 결론이 더 흥미롭습니다. 하네스를 단 저가 모델의 1회 시도 비용은 약 0.27달러였습니다. 하네스 없는 최상위 모델은 약 0.41달러였습니다.
검증 장치의 토큰과 시간 비용을 모두 더해도 33% 저렴하면서, 신뢰성은 동일했습니다.
잘하는 모델에게 검증은 낭비지만, 들쭉날쭉한 모델에게 검증은 낭비를 고치는 장치입니다.
셋. 실패의 정체: 몰라서가 아니라 까먹어서
실험에서 주목할 부분은 실패한 결과물의 수준입니다. 하네스 없이 실패한 저가 모델의 결과물도 178개 검증 중 94.8%를 통과했습니다. 전체를 못 만든 것이 아니라, 구석의 문제 몇 개에 걸린 것이었습니다.
빠진 곳에도 일정한 패턴이 있었습니다.
첫째, 시간 초과 상황의 설계였습니다. 외부 서비스의 응답이 늦으면 "접수됨(202)"으로 답하고, 나중에 결과를 확인하게 만들라는 요구가 있었습니다. 이 흐름이 뚫려 있었습니다.
둘째, 메시지 계약 위반이었습니다. Kafka로 메시지는 도착했지만 형식이 요구사항과 달랐습니다. 없어야 할 헤더가 추가되어 있거나, 배열이어야 할 필드에 null이 들어간 사례였습니다.
셋째, 사소한 설정 오타였습니다. API 키 환경변수 이름이 어긋난 사례도 있었습니다. 멀쩡해 보이는 서비스가 외부 연동에서 통째로 실패했습니다.
공통점은 이 요구사항들이 모두 명세에 적혀 있었다는 점입니다. 실험자는 이런 현상을 주의 누락(attention lapse)이라고 불렀습니다. AI가 몰라서 놓친 것이 아니라, 여러 작업을 동시에 다루느라 놓친 것입니다.
하네스는 이 문제에 맞는 해법입니다. 검증이 빨간불을 켜면 잊혀진 요구사항이 다시 눈앞에 돌아옵니다. 실험은 이 원리를 실행 가능한 주의(executable attention)라고 정리했습니다.
넷. 실무 적용: 검증 시점을 모델이 결정합니다
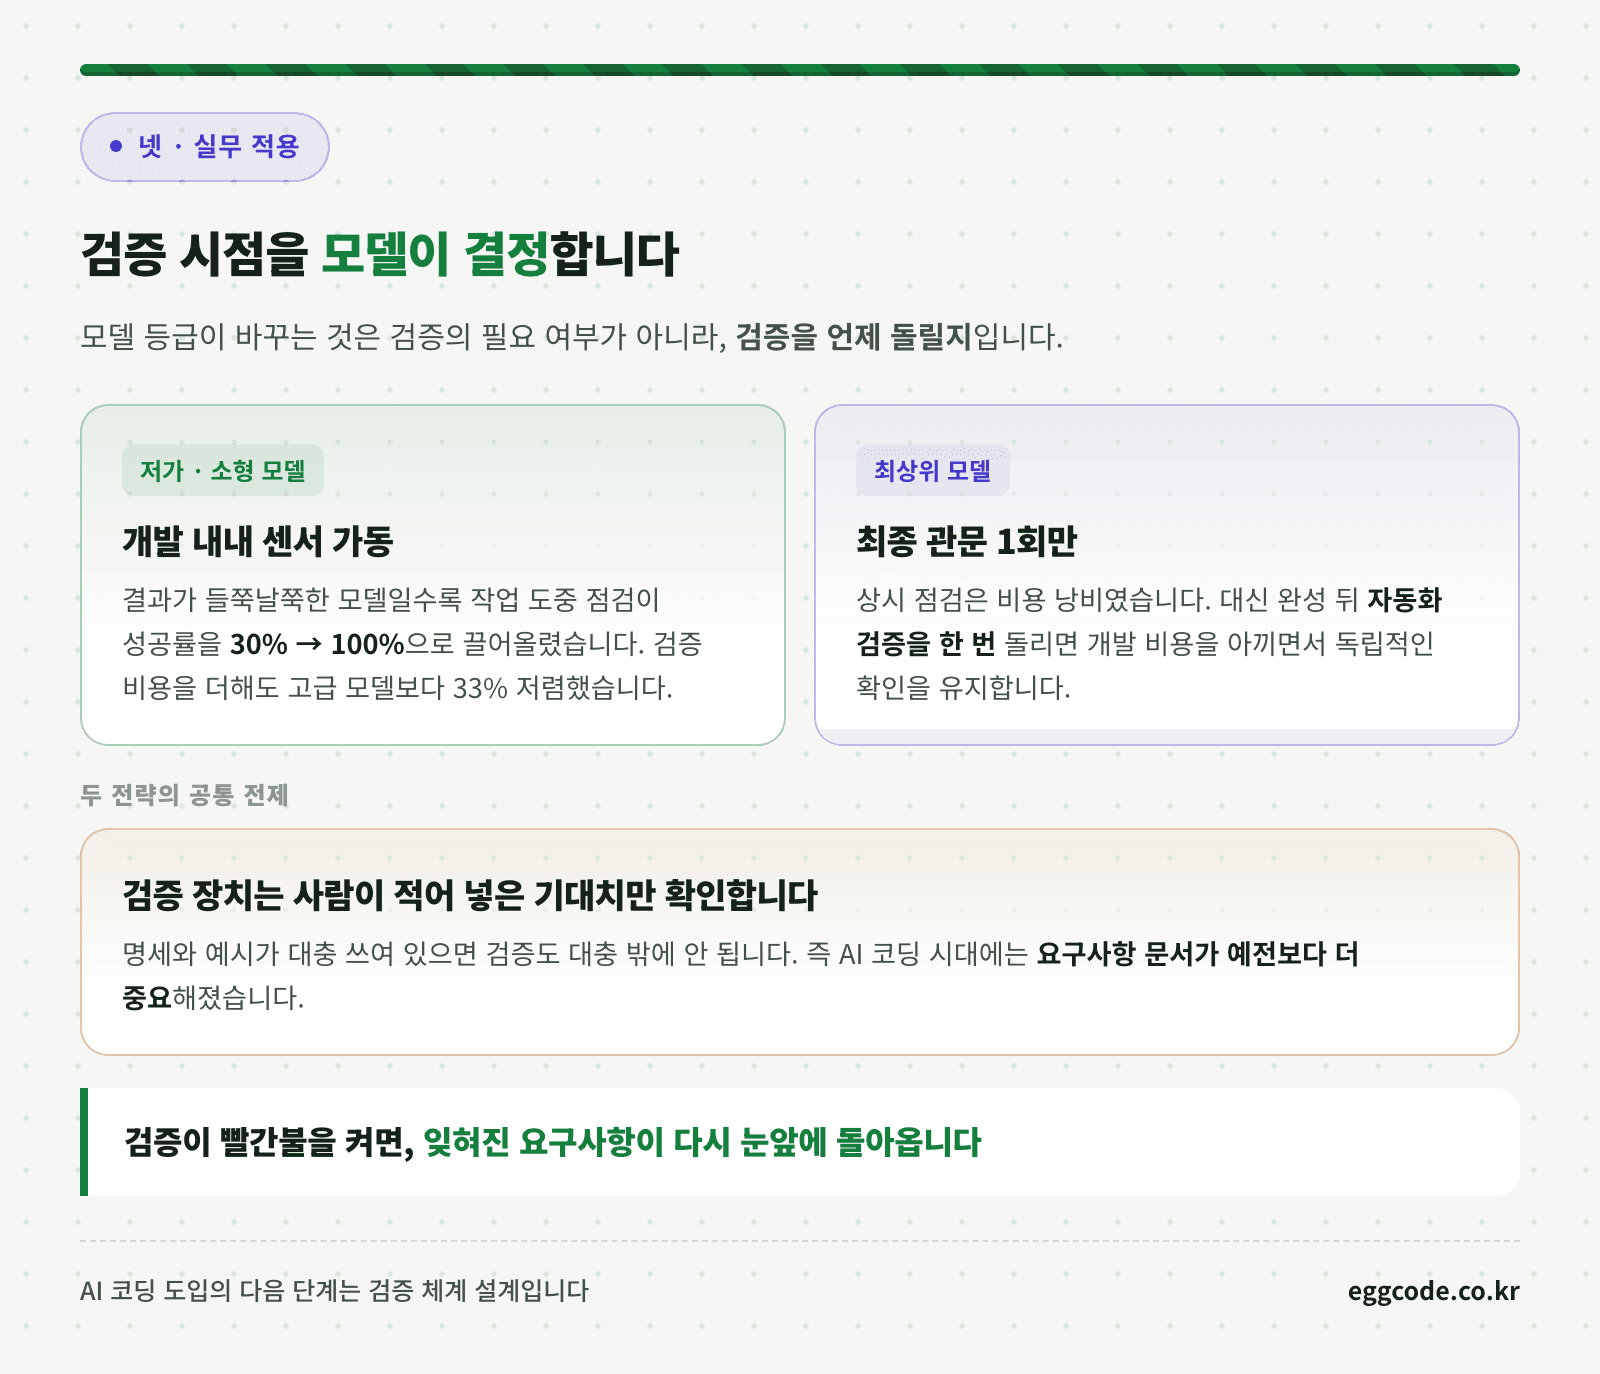
이 실험이 주는 교훈은 명확합니다. 모델 등급이 바꾸는 것은 검증의 필요 여부가 아니라, 검증을 언제 돌릴지입니다.
저가 모델이나 소형 모델을 쓴다면 개발 내내 센서를 가동하는 편이 좋습니다. 결과가 들쭉날쭉한 모델일수록 작업 도중의 점검이 성공률을 30%에서 100%로 끌어올렸습니다.
최상위 모델을 쓴다면 상시 점검은 비용 낭비입니다. 대신 완성된 뒤 최종 관문에서 자동화 검증을 한 번만 돌리면 됩니다. 개발 비용은 아끼면서 독립적인 확인은 유지하는 방법입니다.
전제 조건도 있습니다. 검증 장치는 사람이 적어 넣은 기대치만 확인할 수 있습니다. 명세와 예시가 대충 쓰여 있으면 검증도 대충 밖에 안 됩니다.
즉 AI 코딩 시대에는 요구사항 문서가 예전보다 더 중요해졌습니다.
마무리하며
이번 실험은 하나의 서비스 과제를 10회씩 반복한 결과입니다. 모든 상황으로 일반화하기에는 이르다는 한계가 있습니다.
다만 방향은 분명합니다. 하네스 뜻을 한 줄로 정리하면 "모델의 강약과 무관하게 필요하고, 형태만 다른 검증 장치"입니다. 싼 모델을 검증으로 신뢰할 수 있게 만든 것이 이번 결과의 의미입니다.
AI 코딩을 도입하려는 팀에게 선택지가 넓어진 셈입니다.
에그코드는 AI 코딩 도구를 단순히 쓰는 데서 끝내지 않고, 검증 체계까지 설계에 포함해서 개발합니다. 서비스 기획부터 개발과 운영까지, 운영 경험을 바탕으로 함께합니다.
함께 읽어보세요 — AI 에이전트 뜻과 답이 매번 달라지는 이유 · TDD 테스트 주도 개발, 개발회사가 일하는 방식 · 클로드와 GPT를 섞어 쓰는 4가지 기준